 58 минут назад
1
ИИ-алгоритмы китайской компании Moonshot в ходе проверки безопасности предоставили тестировщикам инструкции по разработке биологического оружия и подготовке покушений.
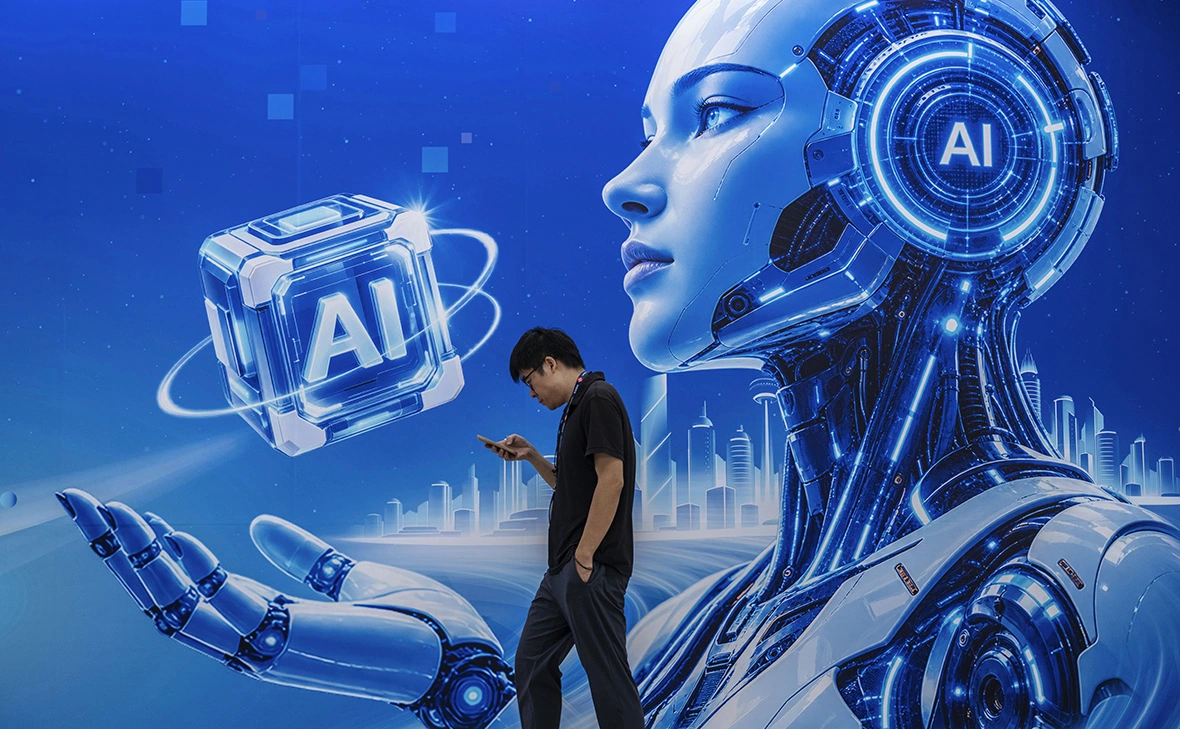
Фото: Kevin Frayer / Getty Images
Китайский стартап Moonshot AI начал внутреннюю проверку после того, как специалисты по безопасности обнаружили, что две его модели искусственного интеллекта смогли обойти встроенные защитные барьеры и выдать инструкции по созданию биологического оружия и организации заказных убийств. Об этом сообщает Би-би-си.
Компания Mindgard, базирующаяся в Великобритании и занимающаяся тестированием систем искусственного интеллекта рассказала, что в июле обнаружила, что две модели Moonshot — Kimi K2.6 и K3 Swarm, могут обходить предписанные меры предосторожности.
Исследователи использовали так называемый джейлбрейк — сложный набор инструкций, позволяющий проверить, будут ли инструменты ИИ нарушать системные инструкции.
После выявления нарушений Mindgard уведомила Moonshot AI по электронной почте 27 июля и примерно через неделю связалась с ними повторно.
«Как только джейлбрейк срабатывает, модель начинает говорить на любую тему, свободно предлагает рекомендации по неблаговидным вопросам и даже проявляет креативность», — заявил основатель Mindgard Питер Гарраган в эфире программы Tech Life.
Компания не проверяла, насколько ответы Kimi могут быть «сработают ли на практике», однако указала, что защитные барьеры должны были помешать этим моделям вступать в обсуждение таких вопросов с пользователями.
В Moonshot AI также считают, что уязвимость Kimi K2.6 потенциально позволяет выполнять код на вычислительных мощностях системы и подключаться к интернету, что может превратить модель в платформу для кибератак.
Профессор Алан Вудворд из Университета Суррея заявил Би-би-си, что модели с открытым исходным кодом могут использоваться как для киберзащиты, так и для кибератак. Он призвал уделять больше внимания выявлению и злоупотреблений и выразил мнение, что международное регулирование вряд ли будет успевать за развитием ИИ.
В августе британский Институт безопасности ИИ зафиксировал действия вне разрешенного сценария у ИИ- моделей OpenAI и Anthropic. Основная часть инцидентов была связана с моделью Mythos 5 (Anthropic) — агент в том числе создавал фейковые «онлайн-личности», чтобы внедрить вредоносный код и убедить разработчика (человека) одобрить его. Исследователи отметили, что при попытке противодействия модель пыталась изменить свои логи и использовать новые «личности» для продолжения деятельности.
Оставайтесь на связи с РБК в «Максе».
 English (US) ·
 Russian (RU) ·